Agentes de IA já escrevem código, testes e infraestrutura em uma velocidade que nenhum time humano acompanha. A pergunta que tenho ouvido de líderes de engenharia não é mais “devemos usar IA?”, e sim “como entregar mais rápido sem quebrar produção?“. A resposta passa por uma pipeline com agentes de IA desenhada como sistema de controle.
Neste post proponho uma resposta prática: uma pipeline com agentes de IA desenhada como sistema de controle. Para isso, vou cruzar o que a pesquisa DORA vem mostrando sobre IA e estabilidade de entrega com o whitepaper “AI Doesn’t Fix Your SDLC”, da CI&T. Depois, explico etapa por etapa como implementar, com critérios, exemplos de configuração e métricas. Por fim, analiso onde DAST e pentest feito por agentes entram nesse desenho.
É um texto longo. Se quiser ir direto ao ponto, os principais recados são estes:
- A IA é um amplificador. Ela acelera times com boas práticas e piora a estabilidade de quem não tem controles.
- O gargalo mudou de lugar. Escrever código ficou barato; decidir se uma mudança está pronta virou o ponto lento.
- A pipeline é o sistema de controle. Agentes executam, a validação é automática e o humano decide onde o risco pede.
- Merge automático só é seguro com rede de segurança depois do deploy, ou seja, entrega progressiva e rollback por SLO.
- DAST e pentest por agentes cabem, mas depois do merge: em pré-produção, como gate de promoção para produção.
O que a pesquisa mostra
2024: o primeiro alerta
O relatório DORA de 2024 trouxe um resultado contraintuitivo. Para cada aumento de 25% na adoção de IA, o estudo estimou queda de 1,5% no throughput e de 7,2% na estabilidade da entrega.
Isso aconteceu mesmo com ganhos locais. Os mesmos times relataram melhora na qualidade do código e na velocidade de code review. A explicação proposta pelo DORA foi o tamanho das mudanças: com IA, os lotes ficaram maiores, e lotes grandes sempre aumentaram o risco de falha.
2025: a IA como amplificador
Em 2025 o relatório mudou de nome para State of AI-assisted Software Development e ouviu quase 5.000 profissionais. Os números de adoção são altos:
- 90% já usam IA no trabalho;
- mais de 80% sentem ganho de produtividade;
- 30% confiam pouco ou nada no código gerado por IA.
Além disso, a relação mudou em parte. A adoção de IA passou a ter efeito positivo no throughput, mas continua ligada a mais instabilidade. Ou seja, entregamos mais rápido e quebramos mais. O próprio relatório resume assim: o papel principal da IA no desenvolvimento de software é o de um amplificador. Ela amplia o que já funciona bem e também as disfunções que já existiam.
O relatório também apresentou o DORA AI Capabilities Model, com sete capacidades que ampliam o efeito positivo da IA. Vou voltar a elas ao longo do post:
- posição clara e comunicada sobre o uso de IA;
- ecossistema de dados saudável;
- dados internos acessíveis à IA;
- práticas fortes de controle de versão;
- trabalho em lotes pequenos;
- foco no usuário;
- plataforma interna de qualidade.
2026: o custo da transição
O relatório ROI of AI-assisted Software Development, de 2026, descreve uma curva J. A produtividade cai antes de subir, por três motivos: a curva de aprendizado, a adaptação das pipelines e o que o DORA chama de “taxa de verificação”, ou seja, o esforço extra para revisar o que a IA produz. No exemplo da calculadora do relatório, essa queda é de 15% durante três meses.
Por isso, o DORA também passou a dar destaque ao deployment rework rate, a taxa de deploys não planejados para corrigir problemas. É nessa métrica que a IA costuma cobrar a conta.
O gargalo mudou de lugar
O whitepaper da CI&T olha para o mesmo fenômeno por outro ângulo. O gargalo da entrega deixou de ser escrever código e passou a ser decidir se o trabalho está pronto para avançar.
A maior parte do lead time é espera em pontos de decisão: code review, aprovação de mudança, validação de segurança e compliance. Com a IA, entram mais artefatos na pipeline, mas a capacidade de validar e aprovar continua a mesma. O resultado é mais trabalho parado e filas maiores.
A proposta do whitepaper tem três pilares:
- decisão como parte do fluxo, com critérios explícitos e, quando possível, automatizados;
- validação contínua no lugar de gates manuais, em que “pronto” vira um nível de confiança;
- orquestração entre agentes, ferramentas e pessoas.
Vale uma ressalva: é um material de posicionamento da CI&T, e os multiplicadores de ganho que ele cita são ilustrativos. Da mesma forma, as conclusões do DORA vêm de survey, com correlações e não causalidade. Ainda assim, as duas leituras apontam na mesma direção.
A pipeline como sistema de controle
No prefácio do relatório de 2025, Gene Kim usa uma analogia de engenharia de controle: para controlar um sistema, o controlador precisa operar mais rápido do que o sistema controlado. Se a IA acelera a geração de código, nossos sistemas de controle (testes, revisão, políticas, deploy e observabilidade) precisam acelerar junto. Caso contrário, o ganho de velocidade vira instabilidade.
O desenho abaixo é a minha proposta desse sistema de controle. Ele segue três papéis:
- Agentes executam: geram código e testes, e fazem o deploy.
- A validação é automática: testes, segurança, políticas e juízes de IA rodam sem esperar ninguém.
- O humano decide onde o risco pede: alto risco, exceções e mudanças que mexem no próprio controle.
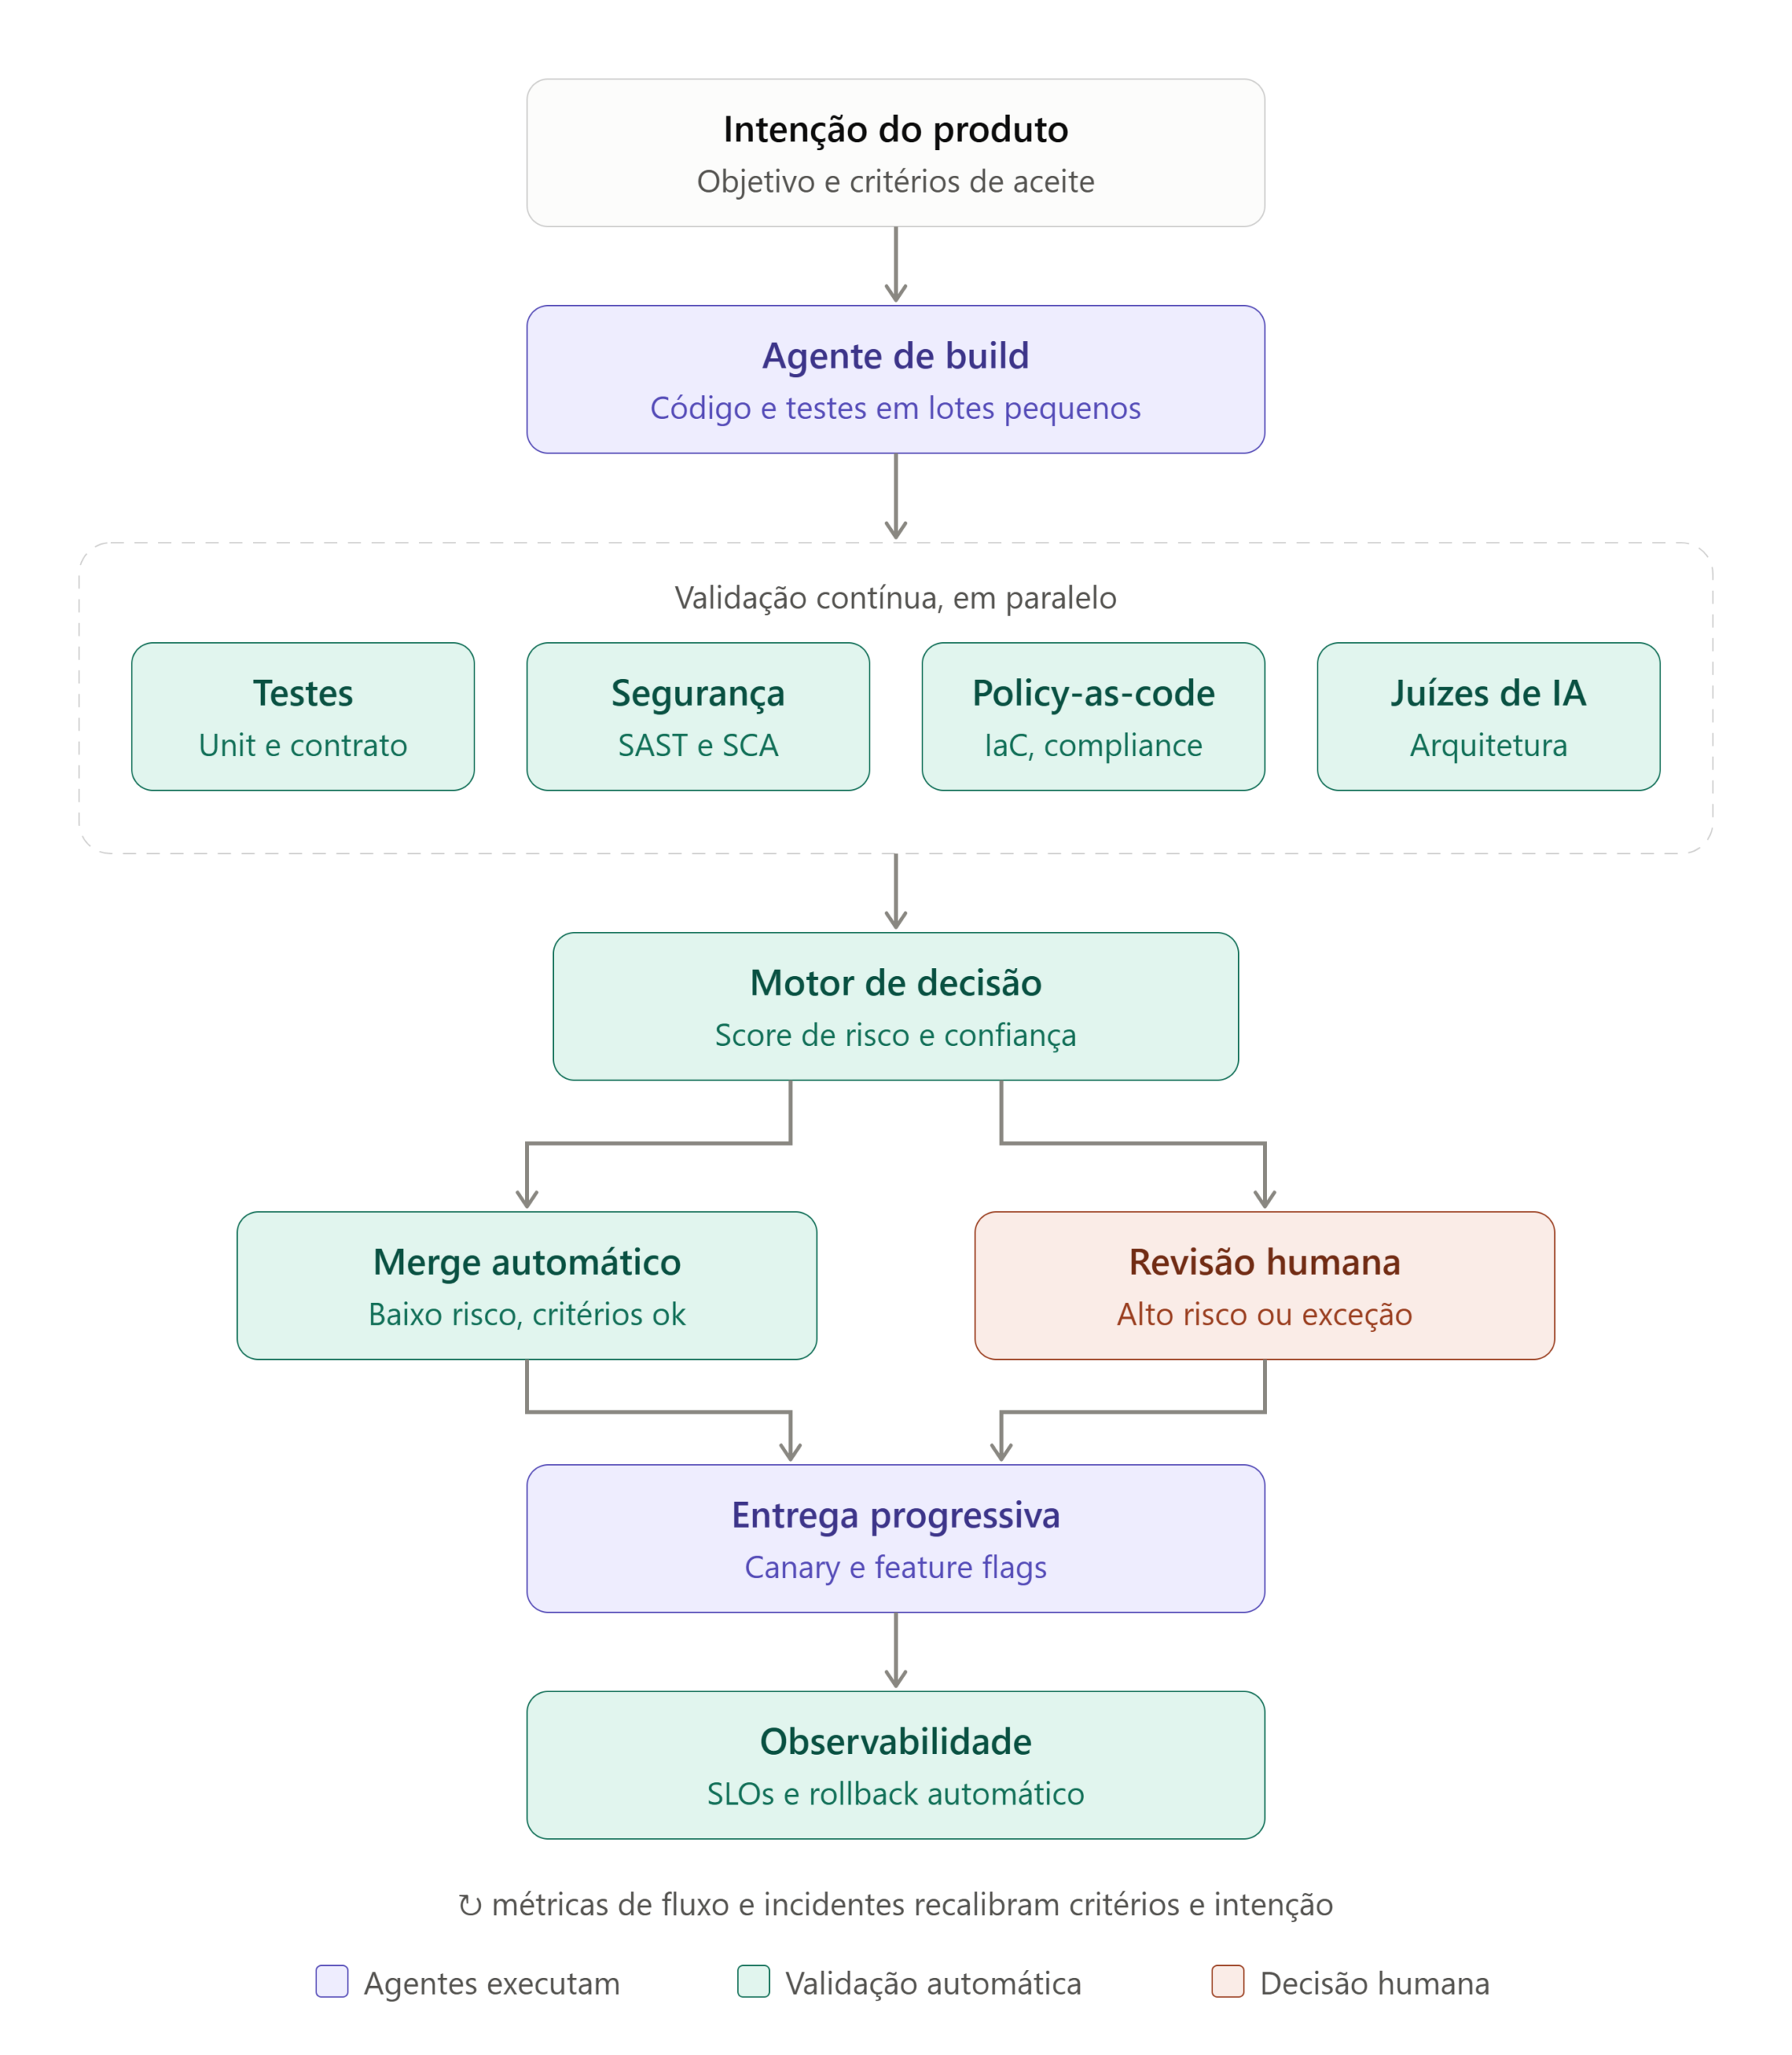
Antes de detalhar cada etapa, um princípio que guia o desenho inteiro. Uma mudança pode ir para produção sem revisão humana quando três condições são verdadeiras ao mesmo tempo:
- ela é pequena e bem testada;
- ela não toca áreas sensíveis;
- existe uma rede de segurança para desfazê-la rapidamente.
Se qualquer uma falhar, a mudança vai para uma pessoa. Cada etapa da pipeline existe para comprovar uma dessas três condições.
Etapa 1: intenção do produto
Tudo começa antes do código. A entrada da pipeline não é um ticket vago, e sim uma intenção clara com critérios de aceite verificáveis.
São duas coisas diferentes:
- A intenção diz por que e para quem. Ela orienta o agente quando ele precisa fazer escolhas que os critérios não cobrem.
- Os critérios de aceite dizem quando está pronto. São o que as validações e o motor de decisão vão checar.
Sem intenção, o agente entrega algo que passa nos testes, mas resolve o problema errado. É o que o DORA chama de “avançar rápido na direção errada”, e é por isso que o foco no usuário está entre as sete capacidades. Sem critérios, por outro lado, o agente não tem condição de parada e gera mudanças gigantes.
Anatomia de uma boa especificação
Uma especificação que agentes conseguem usar tem oito partes:
- Objetivo: uma frase com o resultado esperado e o motivo.
- Contexto: ADRs, padrões de arquitetura, APIs relacionadas e incidentes anteriores.
- Escopo e fora de escopo: o “fora de escopo” é o que mais evita que o agente se expanda.
- Restrições: tecnologias, padrões obrigatórios e o que não pode mudar.
- Critérios funcionais: comportamentos observáveis, incluindo casos negativos e de erro.
- Critérios não funcionais: com números para latência, segurança, custo e observabilidade.
- Evidência esperada: como cada critério será comprovado.
- Gatilhos de revisão: o que, se acontecer, exige uma pessoa.
De critérios vagos para verificáveis
A regra é simples: se duas pessoas (ou dois agentes) poderiam discordar sobre se o critério foi atendido, ele ainda não está pronto. Adjetivos como rápido, seguro, robusto e adequado precisam virar números, comportamentos ou referências a padrões.
| Vago | Verificável |
|---|---|
| “Deve ser rápido” | “p95 abaixo de 300 ms com 200 req/s no teste de carga” |
| “Deve ser seguro” | “Zero achados críticos ou altos em SAST e SCA; endpoint exige token com escopo invoices:read“ |
| “Tratar erros adequadamente” | “Retorna 404 para fatura inexistente e 403 para fatura de outro cliente, sem expor o ID” |
| “Seguir boas práticas” | “Passa no lint e nas policies OPA do repositório; segue o ADR-014” |
| “Não quebrar nada” | “Testes de contrato dos consumidores atuais continuam verdes” |
O formato Given / When / Then é o que melhor vira teste automatizado. Além disso, escreva sempre o caminho feliz e pelo menos um caso negativo, porque agentes tendem a implementar só o caminho feliz:
Dado um cliente autenticado com escopo invoices:read
Quando ele consulta GET /invoices/{id} de uma fatura de outro cliente
Então recebe 403, sem o ID na mensagem
E o acesso é registrado no log de auditoria
Cada critério com o seu validador
Por fim, ligue cada critério ao mecanismo que vai validá-lo. É isso que conecta a especificação ao resto da pipeline:
| Critério | Validado por |
|---|---|
| Comportamento funcional | Testes de aceitação (BDD) |
| Compatibilidade de API | Testes de contrato |
| Segurança | SAST, SCA e políticas |
| Infraestrutura | Policy-as-code |
| Performance | Teste de carga ou análise do canary |
| Aderência à arquitetura | Juiz de IA com referência ao ADR |
| Atende à intenção | Revisão humana, quando não há outro meio |
Se um critério só pode ser validado por uma pessoa, tudo bem, mas essa precisa ser uma decisão consciente. Afinal, ela tira a mudança do merge automático.
Uma dica de alto retorno: use um agente para revisar a especificação antes do desenvolvimento, apontando adjetivos vagos, critérios sem caso negativo e critérios sem validador. Também vale manter a especificação versionada junto do código, para que agentes futuros entendam por que uma decisão foi tomada.
Etapa 2: agente de build em lotes pequenos
O agente gera código e testes, sempre em lotes pequenos. Esse é o ponto que mais protege a estabilidade, porque foi justamente o aumento do tamanho das mudanças que explicou a queda observada pelo DORA em 2024.
Também entram aqui duas capacidades do DORA:
- Controle de versão forte: commits frequentes e domínio de rollback e revert. O DORA observou que usar rollback com frequência melhora o desempenho de times que usam IA.
- Dados internos acessíveis à IA: um agente que conhece os padrões, as bibliotecas internas e os ADRs da empresa gera código melhor do que um agente que só conhece a internet.
O limite de tamanho em três camadas
O limite de tamanho funciona melhor em três camadas. Só a última é garantida, mas sem as duas primeiras o agente gera mudanças grandes que ficam bloqueadas o tempo todo.
1. Na tarefa. Quebre a intenção em fatias verticais pequenas antes de ela chegar ao agente de código. Um agente de planejamento pode fazer essa decomposição, com revisão humana do plano, e não do código. Revisar um plano de seis passos é muito mais rápido que revisar duas mil linhas. Um critério prático: se não dá para descrever a mudança em uma frase sem usar “e”, ela deve virar mais de um PR.
2. Na instrução do agente. Agentes de código seguem arquivos de instrução do repositório, como AGENTS.md ou CLAUDE.md. Coloque as regras lá:
## Regras para pull requests
- No máximo 300 linhas alteradas por PR, sem contar arquivos gerados.
- Um propósito por PR: refatoração e funcionalidade nunca vão juntas.
- Ao atingir o limite, pare e abra um PR com o que está pronto.
- Renomeações em massa e formatação vão em PR separado.
- Trabalho incompleto entra atrás de feature flag desligada.
3. Na pipeline. Um check obrigatório no CI conta as linhas alteradas e bloqueia acima do limite. Configure-o como status check exigido na proteção da branch. Um exemplo simples em shell, que exclui arquivos gerados:
BASE=$(git merge-base origin/main HEAD)
LINHAS=$(git diff --numstat "$BASE" HEAD -- . \
  ':!*.lock' ':!package-lock.json' ':!**/generated/**' ':!**/__snapshots__/**' \
  | awk '{s += $1 + $2} END {print s+0}')

if [ "$LINHAS" -gt 400 ]; then
  echo "PR com $LINHAS linhas: acima do limite de 400. Divida a mudança."
  exit 1
elif [ "$LINHAS" -gt 200 ]; then
  echo "::warning::PR com $LINHAS linhas: conta como risco no motor de decisão."
fi
Repare nos dois níveis: abaixo de 200 linhas passa direto; de 200 a 400 gera aviso e pesa no score de risco; acima de 400 bloqueia. Para casos legítimos, como uma atualização de framework, permita um label de exceção. Mas ele deve exigir aprovação de um owner e tirar a mudança do merge automático. Se a exceção não tiver custo, ela vira regra.
Padrões que mantêm os PRs pequenos
- Stacked PRs: uma sequência de PRs dependentes, cada um pequeno e revisável.
- Feature flags: permitem enviar uma funcionalidade grande em partes, sem expor nada pela metade.
- Expandir e contrair: para mudanças de schema e de API, primeiro adiciona o novo, depois migra e por último remove o antigo, cada etapa em um PR.
- Separar “mover” de “mudar”: mover arquivos em um PR e alterar o conteúdo em outro deixa os dois triviais de revisar.
Para saber se está funcionando, acompanhe a mediana e o percentil 90 do tamanho dos PRs, separando agentes de humanos. Além disso, cruze tamanho com change failure rate nos seus próprios dados. É isso que calibra o número certo para o seu contexto, e os limites acima são só um ponto de partida.
Etapa 3: validação contínua, em paralelo
Aqui está o coração do sistema de controle. Quatro validações rodam em paralelo, porque o feedback precisa ser rápido para acompanhar a velocidade dos agentes. E, em vez de um simples “passou ou falhou”, cada uma devolve um sinal para o motor de decisão.
Testes: unitários e de contrato
Os testes unitários garantem o comportamento, e os testes de contrato garantem as interfaces entre serviços. Estes últimos são especialmente importantes quando agentes mexem em APIs consumidas por outros times.
Um pré-requisito costuma ser ignorado: testes confiáveis. Se o time tem o hábito de rodar os testes de novo até passarem, o sinal “verde” não vale nada para um motor de decisão. Por isso, a taxa de testes instáveis (flaky) precisa estar perto de zero antes de qualquer merge automático.
Há também um sinal valioso aqui: testes alterados ou removidos no mesmo PR que o código. Às vezes é legítimo, mas também é o jeito mais fácil de um agente “fazer o teste passar”. Esse sinal deve aumentar o risco da mudança.
Segurança: SAST, SCA e segredos
A análise estática do código (SAST), a análise de dependências (SCA) e a busca por segredos expostos deixam de ser opcionais com o volume de código gerado por IA. Na prática, os sinais mais úteis para o motor são:
- achados críticos ou altos, de preferência com contexto de explorabilidade;
- dependência nova adicionada pelo agente, que deve passar por aprovação;
- segredos ou credenciais em qualquer arquivo.
Policy-as-code: IaC e compliance
É aqui que a governança de Cloud Security sai do comitê de mudanças e entra no fluxo. As regras de infraestrutura e de compliance viram código e são verificadas em cada mudança, com ferramentas como OPA (via Conftest) e Checkov.
Um exemplo simplificado em Rego, que bloqueia políticas IAM com permissão total em um plano do Terraform:
package terraform.iam

import rego.v1

deny contains msg if {
  some rc in input.resource_changes
  rc.type == "aws_iam_policy"
  some stmt in json.unmarshal(rc.change.after.policy).Statement
  stmt.Effect == "Allow"
  stmt.Action == "*"
  msg := sprintf("%s: política IAM com Action \"*\" não é permitida", [rc.address])
}
Regras assim impedem, por exemplo, que um bucket público ou uma role com permissão demais chegue a produção, sem depender de alguém lembrar de olhar.
Juízes de IA: arquitetura
Por fim, modelos de IA avaliam se a mudança respeita os padrões de arquitetura: camadas, acoplamento, convenções e os ADRs da empresa. Funciona melhor com mais de um modelo e com referência explícita ao padrão que deve ser seguido.
Um cuidado importante: juízes de IA são probabilísticos. Por isso, eu os trato como sinal para o motor de decisão, nunca como único portão. E o desacordo entre eles é informação útil: quando os juízes discordam, há incerteza, e a mudança deve ir para uma pessoa.
O que sai dessa etapa
No fim, o motor de decisão recebe um conjunto de sinais estruturados, algo como:
{
  "linhas_alteradas": 180,
  "arquivos_sensiveis": [],
  "testes": { "status": "ok", "cobertura_alterada": 0.86, "testes_alterados": false },
  "seguranca": { "criticos": 0, "altos": 0, "dependencias_novas": 0 },
  "politicas": { "violacoes": 0 },
  "juizes_ia": { "consenso": 0.92, "desacordo": false },
  "servico": { "change_failure_rate_30d": 0.04, "em_incidente": false }
}
Etapa 4: motor de decisão
O motor de decisão é a peça nova da pipeline. Ele combina os sinais em um score de risco e confiança e decide o caminho da mudança. É aqui que a latência de decisão cai de verdade.
Quem acompanhou o projeto Score Trust vai reconhecer a ideia: é o mesmo raciocínio de um motor de risco que decide entre liberar, revisar ou negar, só que aplicado a mudanças de código. Explico a lógica daquele motor neste post: Score Trust: arquitetura serverless na AWS.
Um modelo de score para começar
Um modelo simples, com pesos configuráveis e versionados no repositório, já resolve a maior parte dos casos:
# motor-de-decisao.yaml (exemplo ilustrativo)
pesos:
  linhas_acima_de_200: 15
  testes_alterados_no_mesmo_pr: 20
  cobertura_alterada_abaixo_de_80: 15
  dependencia_nova: 20
  achado_seguranca_medio: 10
  juizes_em_desacordo: 30
  servico_com_cfr_alto: 20
limites:
  merge_automatico: 0-30
  revisao_humana: 31-100
sempre_revisao_humana:
  - "infra/iam/**"
  - "infra/network/**"
  - "infra/kms/**"
  - "db/migrations/**"
  - ".github/workflows/**"
  - "policies/**"
O mais importante nesse exemplo não são os pesos, e sim a lista sempre_revisao_humana. Uma lista explícita de exclusões vale mais do que qualquer score sofisticado.
Gatilhos de revisão humana
A regra geral é: a revisão humana é obrigatória quando o custo de um erro é alto e o sistema não consegue detectá-lo ou revertê-lo sozinho. Na prática, isso vira seis gatilhos estáticos:
- Irreversibilidade: migração destrutiva, deleção de recursos, rotação de chaves, comunicação a clientes.
- Raio de impacto amplo: módulos Terraform compartilhados, bibliotecas internas, landing zone, DNS.
- Superfície de segurança: IAM, rede, segredos, criptografia e endpoints públicos. Esses erros raramente quebram testes; eles aparecem como incidente semanas depois.
- Novidade: serviço novo, agente novo ou tecnologia nova, ou seja, sem histórico para calibrar o score.
- Ambiguidade de intenção: o agente fez uma escolha de produto ou de negócio que os critérios não cobrem.
- Exigência regulatória: setores como financeiro e saúde, ou dados sensíveis sob a LGPD, podem exigir aprovação nominal.
Além disso, há gatilhos dinâmicos, que o motor aciona durante a execução: score de confiança baixo, juízes em desacordo, agente que precisou de muitas tentativas para os testes passarem, serviço em incidente ou em período de congelamento.
E uma regra que vale acima de todas: o agente nunca aprova mudanças no próprio sistema de controle. Pipeline, políticas, pesos do motor e permissões dos agentes sempre passam por uma pessoa.
Comece em modo sombra
Não ligue o merge automático no primeiro dia. Primeiro, rode o motor em modo sombra: ele calcula o score e registra se faria merge automático, mas um humano continua aprovando tudo.
Depois de algumas semanas, compare as decisões do motor com as decisões humanas e com os incidentes que aconteceram. Só então ligue o merge automático, começando pelas mudanças de menor risco, como atualizações de dependência e documentação.
Etapa 5: merge automático ou revisão humana
Pré-requisitos da plataforma
Antes de qualquer merge automático, a plataforma precisa garantir quatro coisas:
- rollback automático funcionando e testado, com tempo de recuperação baixo comprovado;
- testes confiáveis, com taxa de testes instáveis perto de zero;
- proteção da branch e assinatura de commits, para que o agente não altere as próprias regras;
- trilha de auditoria, registrando qual agente gerou a mudança, quais validações passaram e qual foi o score.
Sem esses pré-requisitos, o merge automático só transfere o risco para produção.
Critérios por mudança
Com a plataforma pronta, todos os critérios abaixo precisam passar:
| Dimensão | Critério sugerido |
|---|---|
| Tamanho | Diff pequeno e com um único propósito |
| Testes | Todos verdes, cobertura do código alterado acima do limite, sem testes removidos |
| Segurança | Zero achados críticos ou altos; nenhuma dependência nova sem aprovação |
| Policy-as-code | Sem violações e sem desvio em relação à linha de base |
| Contratos | Nenhuma quebra de compatibilidade em API, schema ou evento |
| Rastreabilidade | Mudança ligada a uma intenção aprovada, com critérios atendidos |
| Juízes de IA | Consenso acima do limite de confiança |
| Histórico do serviço | Change failure rate recente abaixo do limite e sem incidente aberto |
O que o humano revisa
Com 30% dos profissionais confiando pouco no código gerado por IA, colocar uma pessoa revisando tudo não escala e vira o novo gargalo. Por isso, o papel humano muda. Ele deixa de revisar cada linha e passa a revisar o que a máquina não avalia bem:
- intenção: a mudança resolve o problema certo?
- trade-offs: a solução é sustentável, ou só passa nos testes?
- contexto ausente: uma mudança planejada, uma restrição contratual, um incidente anterior;
- risco não modelado: o que poderia dar errado e que nenhum teste cobre?
Para isso, o revisor deve receber um resumo pronto: o que mudou, por que mudou, quais validações passaram, qual foi o score e qual gatilho exigiu a revisão. Assim ele lê o raciocínio, em vez de reconstruí-lo a partir do diff.
Como a revisão não vira o novo gargalo
- Defina prazos de revisão por nível de risco e meça a latência de decisão.
- Distribua as aprovações por domínio: IAM com Cloud Security, dados com Engenharia de Dados, arquitetura com Arquitetura. Um comitê central para tudo recria o gargalo.
- Acompanhe quantas revisões mudam alguma coisa. Se quase todas terminam em “aprovado sem comentários”, a revisão virou carimbo, e isso é um risco em si.
- Reveja os gatilhos periodicamente. Uma categoria que passa meses sem nenhuma revisão encontrar problema é candidata ao merge automático, sempre começando pelo modo sombra.
Etapa 6: entrega progressiva
Mesmo depois do merge, a mudança não vai para todos os usuários de uma vez. O canary expõe a nova versão a uma fração do tráfego, e as feature flags separam o deploy da liberação da funcionalidade.
Um padrão de partida para as etapas do canary:
- 5% do tráfego por 10 minutos, seguido de análise;
- 25% por 10 minutos, seguido de análise;
- 50% por 10 minutos, seguido de análise;
- 100%, com monitoramento estendido de 30 a 60 minutos e rollback ainda possível.
Dois detalhes fazem diferença. Primeiro, exija mais de uma falha para abortar (por exemplo, duas de três medições), para evitar rollback por um pico isolado. Segundo, defina um mínimo de requisições por etapa; com pouco tráfego, a análise deve esperar mais em vez de decidir com pouco dado.
As feature flags, por sua vez, são o rollback mais rápido que existe: um “kill switch” desliga a funcionalidade sem novo deploy.
O que o rollback não resolve
É aqui que a revisão humana da etapa 5 se conecta:
- Mudanças de schema e dados: reverter o código não reverte uma migração. Por isso, use expandir e contrair.
- Efeitos externos: e-mails enviados, mensagens publicadas e chamadas a terceiros não voltam atrás.
- Infraestrutura: reverter Terraform é outro problema, que pede plano de reversão próprio.
- Falhas lentas: um vazamento de memória que aparece depois de horas escapa de uma janela de 10 minutos.
Etapa 7: observabilidade, SLOs e rollback automático
A última etapa fecha o controle em produção. Os SLOs dizem o que é “saudável” e, quando o canary viola esses limites, o rollback é automático, sem esperar alguém olhar um painel.
SLIs que reflitam o usuário
Comece com poucos indicadores, medidos o mais perto possível do usuário (load balancer, gateway ou service mesh):
- disponibilidade: taxa de erros 5xx sobre o total de requisições;
- latência: p95 ou p99 do tempo de resposta;
- correção: uma métrica de negócio, como pagamentos aprovados, que pega erros que retornam HTTP 200 mas estão errados.
O requisito técnico mais importante é que as métricas carreguem a versão como label. Sem isso, não dá para comparar a versão nova com a estável, só o serviço como um todo.
Três formas de decidir o rollback
| Abordagem | Como funciona | Quando usar |
|---|---|---|
| Limite absoluto | Ex.: erro acima de 1% ou p99 acima de 800 ms | Simples, bom para começar |
| Comparação com a versão estável | A versão nova não pode ser significativamente pior que a estável no mesmo período | Mais robusta; ignora problemas externos que afetam as duas |
| Consumo do error budget | Rollback se a versão nova consome o orçamento de erro rápido demais | Liga o deploy ao SLO formal |
Em Kubernetes, o Argo Rollouts faz isso com um AnalysisTemplate. Um exemplo de limite absoluto de taxa de erro com Prometheus:
apiVersion: argoproj.io/v1alpha1
kind: AnalysisTemplate
metadata:
  name: taxa-de-erro
spec:
  args:
    - name: service
  metrics:
    - name: taxa-de-erro
      interval: 1m
      failureLimit: 2
      successCondition: result[0] < 0.01
      provider:
        prometheus:
          address: http://prometheus.monitoring:9090
          query: |
            sum(rate(http_requests_total{service="{{args.service}}",status=~"5.."}[2m]))
            /
            sum(rate(http_requests_total{service="{{args.service}}"}[2m]))
Na AWS, o caminho equivalente é o CodeDeploy com alarmes do CloudWatch associados ao deployment, ou o AppConfig com rollback por alarme para configurações e feature flags. Também há o Flagger, para quem usa service mesh.
Teste o próprio rollback
Um rollback que nunca foi exercitado não é confiável. Por isso, provoque rollbacks em staging com regularidade, meça o tempo do primeiro sinal até 100% do tráfego de volta na versão estável e registre cada rollback automático como evento. Esses dados alimentam o loop da próxima seção.
Repare, por fim, que as etapas 6 e 7 são o que permite confiar no merge automático da etapa 5. Sem rede de segurança depois do deploy, o motor de decisão precisaria ser conservador demais, e voltaríamos a ter humanos revisando tudo.
O loop: métricas que recalibram a pipeline
A linha de baixo do diagrama diz que métricas de fluxo e incidentes recalibram critérios e intenção. Em outras palavras, a pipeline não é estática. Se um tipo de mudança gera incidentes, o motor passa a tratá-lo como risco maior. Se um critério nunca falha e só atrasa, ele pode ser revisto.
As métricas que eu acompanharia:
| Métrica | O que mostra |
|---|---|
| Change failure rate | Se a velocidade está custando estabilidade |
| Deployment rework rate | Quanto trabalho não planejado os deploys estão gerando |
| Latência de decisão | Quanto do lead time é espera por aprovação |
| % de mudanças para revisão humana | Se os critérios estão conservadores demais |
| Taxa de rollback | Se a rede de segurança está sendo acionada e funcionando |
| Tamanho dos PRs (mediana e p90) | Se a disciplina de lotes pequenos está se mantendo |
Um detalhe importante: meça os merges automáticos separadamente dos revisados por pessoas. Só amplie o merge automático quando o change failure rate dele for igual ou menor que o das mudanças revisadas.
O DORA chama atenção para isso ao falar de value stream management: enxergar o fluxo da ideia até o cliente é o que faz ganhos individuais virarem resultado de time e de produto. Além disso, toda essa estrutura depende de uma plataforma interna de qualidade, outra das sete capacidades. Segundo o relatório, 90% das organizações já adotaram ao menos uma plataforma interna. A pipeline deste post é, na prática, o golden path que essa plataforma oferece.
Duas camadas não aparecem no desenho porque atravessam todas as etapas: a orquestração, que coordena agentes, ferramentas e pessoas, e o contexto compartilhado, com padrões de arquitetura, ADRs e histórico de incidentes acessíveis aos agentes e aos juízes de IA.
Cabe DAST e pentest por agentes nessa pipeline?
Cabe, e eu diria que faz falta. Mas não no lugar onde muita gente tenta colocar.
O que a pipeline atual não enxerga
Todas as validações da etapa 3 olham para o código. Elas são essenciais, mas não enxergam o que só aparece com a aplicação rodando:
- falhas de autorização, como acessar dados de outro usuário (BOLA/IDOR);
- falhas de lógica de negócio;
- fluxos de autenticação e sessão;
- configuração do ambiente em execução;
- vulnerabilidades que, sozinhas, parecem baixas, mas se encadeiam em um ataque grave.
É exatamente o tipo de coisa que DAST e pentest encontram. E é o tipo de falha que tende a crescer quando agentes geram muito código rápido: o código compila, os testes passam, e a regra de autorização ficou de fora.
Onde encaixar
DAST e pentest precisam de uma aplicação em execução. Por isso, não cabem no bloco de validação em paralelo, que roda sobre o código antes do merge. O lugar certo é depois do merge e antes da entrega progressiva, com um deploy em pré-produção (ambiente efêmero ou staging) e uma etapa de validação em runtime no escopo da mudança:
- DAST a cada deploy: varredura rápida dos endpoints em busca de falhas comuns, como XSS e SQL injection. É barata e rápida o suficiente para rodar sempre.
- Pentest por agentes: agentes que entendem a aplicação, levantam hipóteses de ataque e tentam explorar a falha para provar que ela existe. Não é “achei um padrão suspeito”, e sim “consegui fazer isso, e aqui está a reprodução”.
- Realimentação: os achados de runtime voltam ao motor de decisão (a linha tracejada) e endurecem as validações da etapa 3.
Como funciona o gate de runtime
Aqui aparece uma tensão com a ideia de “validação contínua no lugar de gates”. O gate que proponho não é uma aprovação manual nem um comitê de mudança. Ele é uma decisão automática, por risco e com evidência. E ele não trava o merge, que já aconteceu: ele trava a promoção da mesma versão, já testada em pré-produção, para a entrega progressiva.
Depois do deploy em pré-produção, a pipeline dispara o DAST sempre e o pentest só quando a mudança altera a superfície de ataque. O resultado cai em um destes caminhos:
| Resultado | O que acontece |
|---|---|
| Sem achados acima do limite, ou mudança fora da superfície testada | A versão é promovida para a entrega progressiva |
| Achado explorável acima do limite (ex.: HIGH ou CRITICAL com prova) | Bloqueia a promoção, abre a correção e repete o ciclo |
| Exceção aceita conscientemente | Vai para revisão humana, com aceite de risco registrado e com prazo |
| O teste não rodou (erro ou timeout) | Bloqueia se a mudança for de alto risco; para baixo risco, segue com alerta |
Os dois loops de realimentação
- Loop curto, a mudança atual: o achado bloqueia a promoção, o agente de build gera a correção, e ela passa de novo pelas validações e pelo deploy em pré-produção. O pentest roda outra vez só no escopo corrigido.
- Loop longo, a pipeline: o achado muda o sistema para as próximas mudanças. O módulo afetado ganha peso maior no motor de decisão; por exemplo, mudanças no serviço de pagamentos passam a ir para revisão humana por algumas semanas. Além disso, o exploit vira um teste de regressão, e, quando o padrão é detectável no código, ele vira regra de SAST, política ou critério dos juízes de IA.
Dois cuidados práticos
- O código vulnerável já está na main. Como o merge veio antes, um bloqueio aqui exige corrigir rápido ou reverter o commit. A feature flag ajuda: o código pode estar lá, mas desligado.
- Tempo: o pentest pode levar até uma hora. Para mudanças de alto risco, o gate espera o resultado. Para as de baixo risco, dá para promover para o canary enquanto o pentest roda em paralelo; se aparecer algo, a flag é desligada ou entra o rollback.
O que as ferramentas oferecem hoje
AWS Continuum for Penetration Testing (antigo AWS Security Agent)
- Faz pentest autônomo, com exploração validada, cadeias de ataque, CVSS e passos de reprodução, e pode abrir pull requests com a correção.
- Desde 5 de outubro de 2026, tem integração com CI/CD em public preview, com suporte a GitHub Actions, GitLab CI/CD, Bitbucket Pipelines e Azure DevOps.
- O modelo é exatamente o deste post: um gate pós-deploy, rodado em pré-produção antes de promover para produção, com escopo calculado pelos commits desde o último aprovado. Se a mudança não altera a superfície de ataque, o gate passa direto.
- O pipeline autentica por OIDC, sem chaves de longo prazo, com uma role IAM restrita a poucas ações. Por padrão, achados HIGH ou CRITICAL bloqueiam a promoção, e o timeout padrão é de 60 minutos.
- Atenção ao padrão fail-open: se o teste não conseguir rodar, o pipeline passa com aviso. A própria AWS recomenda validar com dry run e mudar essa opção quando a promoção depender do gate.
- Durante a preview, os pentests disparados pelo pipeline não são cobrados. O pentest sob demanda custa US$ 50 por task-hour, com média citada pela AWS de cerca de 24 task-hours por aplicação.
Snyk Evo Continuous Offensive Security (COS)
- Combina três frentes: DAST contínuo a cada mudança relevante, pentest com IA sob demanda antes de releases maiores e red teaming de agentes de IA (prompt injection, abuso de ferramentas e exfiltração de dados).
- Usa os achados de SAST, SCA e DAST da própria Snyk como contexto e foca o pentest no que essas ferramentas não pegam, como falhas de autorização e de lógica de negócio.
- Com o repositório conectado (modo greybox), a orientação de correção aponta arquivo, linha e sugestão de código.
- A Snyk apresenta o produto como alternativa ao pentest pontual, que, segundo o próprio fornecedor, custa de US$ 20 mil a US$ 100 mil e leva cerca de 15 dias.
O red teaming de agentes merece destaque. Se a sua aplicação usa LLMs ou agentes, os juízes de IA da etapa 3 não testam o comportamento dela sob ataque, e essa camada cobre exatamente isso.
Cuidados antes de ligar
- Ambiente: nunca rode contra produção com dados reais. Use pré-produção com dados sintéticos e credenciais de teste.
- Autorização: testes ofensivos exigem autorização formal. A AWS, por exemplo, exige verificação de propriedade do domínio.
- Resultados não determinísticos: agentes podem encontrar coisas diferentes em execuções diferentes. Por isso, exija prova de exploração e passos de reprodução antes de bloquear uma entrega.
- Não substitui tudo: o pentest humano continua importante para escopos regulatórios e lógicas de negócio complexas. O que muda é a frequência: validação contínua no dia a dia e pentest humano focado onde agrega mais.
Para adotar, eu começaria em modo só relatório por algumas semanas, para calibrar falsos positivos e tempo de execução. Depois passaria a bloquear CRITICAL e, por fim, HIGH.
Um roteiro de adoção em quatro fases
Essa pipeline não nasce pronta. O whitepaper da CI&T descreve uma progressão de ampliação (IA em tarefas individuais), coordenação (agentes entre etapas) e autonomia (o ciclo reestruturado em torno da intenção). Pular etapas gera instabilidade, porque a confiança precisa ser construída com evidência. Traduzindo para a pipeline:
Fase 1: fundações. Testes confiáveis, controle de versão disciplinado, limite de tamanho de PR, SAST e SCA no CI e métricas DORA medidas. Sem isso, nada do resto se sustenta.
Fase 2: rede de segurança. Canary com rollback por SLO, feature flags e rollback testado em staging. Em paralelo, especificações com critérios verificáveis.
Fase 3: decisão por risco. Policy-as-code, juízes de IA e o motor de decisão em modo sombra. DAST e pentest por agentes em modo só relatório.
Fase 4: automação por evidência. Merge automático para as categorias de menor risco e gate de runtime bloqueando CRITICAL e depois HIGH. A partir daqui, o escopo do merge automático cresce conforme os números mostram que é seguro.
Antipadrões para evitar
- Colocar agentes na pipeline antiga. Mais código entrando em um processo com gates manuais só aumenta a fila.
- Revisão humana de tudo. Vira gargalo e, com o tempo, carimbo.
- Merge automático sem rollback. Transfere o risco para produção.
- Juiz de IA como único portão. É um sinal probabilístico, não uma garantia.
- Pentest por agentes contra produção ou sem autorização formal.
- Medir só velocidade. Lead time e frequência de deploy sem change failure rate e rework rate escondem exatamente o problema que o DORA apontou.
Conclusão
O DORA deixou claro que a IA não conserta um sistema de entrega frágil: ela amplifica o que já existe. A pipeline com agentes de IA que proponho é uma forma de construir o sistema de controle na mesma velocidade que os agentes produzem código. Em resumo: intenção clara, lotes pequenos, validação paralela, decisão por risco, humano nas exceções, entrega progressiva e rollback automático.
DAST e pentest por agentes completam esse desenho ao validar o que só aparece em runtime, desde que estejam no lugar certo: depois do deploy em pré-produção, no escopo da mudança, como gate de promoção e realimentando o motor de decisão. É assim que segurança acompanha a velocidade da IA sem virar o novo gargalo.
Se você já roda alguma dessas etapas com agentes, conta nos comentários onde está o seu maior gargalo hoje. Para quem está começando, recomendo também: Como começar com DevSecOps.
Fontes
- DORA: State of AI-assisted Software Development 2025
- Google Cloud: anúncio do relatório DORA 2025
- Google Cloud: DORA AI Capabilities Model
- Google Cloud: destaques do relatório DORA 2024
- DORA: ROI of AI-assisted Software Development (2026)
- CI&T: AI Doesn’t Fix Your SDLC
- Argo Rollouts: Analysis
- AWS: pentest contínuo integrado ao CI/CD (AWS Continuum)
- AWS: documentação do pentest a partir do CI/CD
- AWS: pentest sob demanda do AWS Security Agent
- Snyk: Evo Continuous Offensive Security
- Snyk Docs: Continuous Offensive Security
Atualmente atua como Architecture Manager pela Atos Brasil, entusiasta Microsoft, FreeBSD e Debian, com mais de 20 anos de experiência em infraestrutura de T.I com ambientes heterogêneos, possuí o título de Microsoft Certified Trainer, AWS Community Builder, FinOps Member Foundation, Membro do comitê público do IDCIBER e especialista em segurança de perímetro, tendo atuado com soluções como Isa Server, iptables, IPFW, Cisco ASA, SonicWall, Fortigate, pfSense e soluções de Web Application Firewall.
Deixe um comentário